





V technologickom priemysle sa sotva môžete porozprávať bez toho, aby niekto nespomenul odvodenie, umelú inteligenciu (AI) a strojové učenie (ML). Je však dôležité poznamenať, že hoci sú všetky tieto pojmy vzájomne prepojené, výrazne sa líšia.
V tomto článku vysvetlíme základné rozdiely a zdôrazníme dôležitosť používania technológie okrajovej umelej inteligencie založenej-na tenzorovom spracovaní, najmä v okrajových a vstavaných systémoch. V porovnaní s riešeniami založenými na grafických procesorových jednotkách (GPU) ponúkajú tenzorové procesorové jednotky (TPU) efektívnejší a nákladovo-efektívnejší výkon. Poskytneme tiež niekoľko príkladov použitia, ktoré ilustrujú, kde sa v budúcnosti môžete stretnúť s riešeniami edge AI.
Základy ML a inferencie
ML odkazuje na metodológiu tréningových modelov využívajúcich reprezentatívne údaje, ktoré umožňujú strojom naučiť sa vykonávať úlohy. Tento proces môže byť vysoko výpočtovo náročný a generovať bilióny operácií na nový tréningový dátový bod. Iteratívna povaha tréningového procesu v kombinácii s obrovskými množinami tréningových údajov, ktoré sú potrebné na dosiahnutie vysokej presnosti, vedie k dopytu po extrémne vysokom -výkonnom spracovaní s pohyblivou rádovou čiarkou-. Školenie ML sa najlepšie implementuje ako infraštruktúra dátového centra, kde môžu byť vysoké kapitálové a prevádzkové náklady odôvodnené ich amortizáciou u mnohých zákazníkov.
Inferencia zahŕňa použitie trénovaných modelov na generovanie potenciálnych zhôd pre nové údaje relevantné pre reprezentatívne údaje, na základe ktorých bol model trénovaný. Cieľom inferencie je poskytnúť rýchle odpovede v priebehu milisekúnd. Príklady dedukcie zahŕňajú rozpoznávanie reči,-preklad jazyka v reálnom čase, strojové videnie a rozhodnutia o optimalizácii vkladania reklamy. Aj keď odvodenie vyžaduje len zlomok výpočtového výkonu potrebného na školenie, stále ďaleko presahuje to, čo dokážu poskytnúť tradičné systémy založené na -centrálnej procesorovej jednotke (CPU), najmä pre aplikácie počítačového videnia. To je dôvod, prečo sa toľko spoločností obracia na tenzorové-riešenia akcelerácie-či už ako IP na SoC alebo ako -systémové urýchľovače-na dosiahnutie sub{10}}sekundových časov odozvy požadovaných na okraji. Realita je taká, že stráviť čo i len minútu alebo pár sekúnd spracovaním obrázkov vo vizuálnom systéme nie je veľmi užitočné. Systémy priemyselného videnia hľadajú rýchlosť spracovania{13}}na úrovni milisekúnd.
Oddelenie školenia a záverov
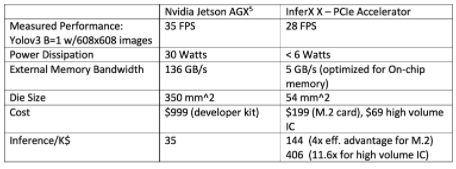
Nasadenie rovnakého hardvéru, ktorý sa používa na školenie na zvládanie úloh odvodenia, môže viesť k nadmernému{0}}poskytovaniu odvodených strojov s akcelerátormi a hardvérom CPU. Riešenia GPU vyvinuté pre ML za posledné desaťročie nie sú nevyhnutne optimálnou voľbou pre rozsiahle-nasadenie technológií odvodzovania ML. Nižšie uvedený diagram dokonale ilustruje porovnanie medzi TPU akcelerátormi a GPU akcelerátormi. Jasne ukazuje, že TPU akcelerátory poskytujú nižšiu spotrebu energie, nižšie náklady a vyššiu efektivitu v porovnaní s GPU -riešeniami AGX, pričom stále poskytujú presvedčivé úrovne výkonu pre odvodené aplikácie.
Ďalším kritickým hľadiskom pri prístupe k riešeniam školenia a odvodzovania ML je softvérové prostredie. Dnes sa používa množstvo populárnych knižníc, ako napríklad CUDA pre GPU NVIDIA, rámce ML ako TensorFlow a PyTorch, optimalizované knižnice modelov pre rôzne platformy, ako je Keras a ďalšie. Tieto sady nástrojov sú nevyhnutné na vývoj a školenie modelov ML, ale aplikácie na odvodenie vyžadujú inú, menšiu sadu softvérových nástrojov.
Inferenčné nástroje sa zameriavajú na spustenie modelov na cieľových platformách. Podporujú prenos trénovaných modelov na platformy, čo môže zahŕňať niektoré transformácie operátorov, kvantizáciu a služby integrácie hostiteľa. To však predstavuje relatívne jednoduchý súbor funkcií v porovnaní s tými, ktoré sú potrebné na vývoj modelu a školenie.
Nástroje na odvodzovanie ťažia z toho, že začínajú so štandardizovanou reprezentáciou modelu. Open Neural Network Exchange (ONNX) je štandardný formát na reprezentáciu modelov ML. Ako už názov napovedá, ide o otvorený štandard spravovaný ako projekt Linux Foundation. Technológie ako ONNX umožňujú oddelenie tréningových a inferenčných systémov a poskytujú vývojárom slobodu výberu rôznych optimalizovaných platforiem pre každú z nich.
Príklady vizuálnych aplikácií
Keďže technológie ML a inferenčných procesorov neustále napredujú a vyvíjajú sa, aplikácie sa množia. Nižšie je uvedených niekoľko miest, kde by ste sa s touto technológiou mohli v budúcnosti stretnúť.
Edge servery v podnikoch, ako sú továrne, nemocnice, maloobchody a finančné inštitúcie. Napríklad v priemyselnom prostredí môže AI pomôcť so správou zásob, detekciou defektov a dokonca aj prediktívnou údržbou skôr, ako nastanú problémy. V maloobchode umožňuje funkcie ako odhad polohy pomocou počítačového videnia na detekciu a analýzu ľudského držania tela. Údaje z tejto analýzy pomáhajú kamenným-a{4}}maloobchodom lepšie porozumieť ľudskému správaniu a návštevnosti v ich predajniach, čo im umožňuje optimalizovať rozloženie predajne pre maximálny predaj a spokojnosť zákazníkov.
Vysoko{0}}presné/vysokokvalitné{1}}zobrazovanie pre aplikácie vrátane robotiky, priemyselnej automatizácie/inšpekcie, lekárskeho zobrazovania, vedeckého zobrazovania, kamier na sledovanie a rozpoznávanie objektov a fotoniky. Napríklad metódy strojového učenia preukázali schopnosť odhaliť rakovinu spracovaním digitálnych röntgenových lúčov. Tento proces zahŕňa vývoj modelu ML navrhnutého na spracovanie röntgenových snímok, zvyčajne pomocou trénovaných algoritmov sémantickej segmentácie na identifikáciu rakovinových lézií. Počas tréningu sa snímky rakoviny identifikované rádiológmi používajú na to, aby sa sieť naučila, čo nie je rakovina, čo je rakovina a ako sa objavujú rôzne typy rakoviny. Čím viac je model ML trénovaný, tým lepšie sa stáva pri maximalizácii správnych diagnóz a minimalizácii nesprávnych diagnóz. To znamená, že strojové učenie sa nespolieha len na inteligentný dizajn modelu, ale rovnako aj na obrovské množstvo (desiatky tisíc až milióny) príkladov starostlivo upravených údajov, kde bola odborne identifikovaná rakovina.
Inteligentné nákupné košíky{0}}Niekoľko spoločností vyvíja a zavádza inteligentné nákupné systémy, ktoré rozpoznávajú produkty nie podľa ich čiarových kódov UPC, ale podľa vizuálneho vzhľadu samotného obalu. Táto funkcia umožňuje nakupujúcim jednoducho umiestniť položky do košíka alebo do pokladničného systému bez toho, aby museli nájsť kód UPC a naskenovať ho laserovým skenerom UPC. Vďaka tejto technológii je nákupný proces presnejší, rýchlejší a pohodlnejší.
Robiť správne rozhodnutie
Spoločnosti musia dnes vyhodnotiť všetky dostupné riešenia a vybrať to optimálne na základe ich konkrétneho prípadu použitia. Nemôžu tiež jednoducho predpokladať, že všetky riešenia AI sú najlepšie implementované na zariadeniach GPU, keďže riešenia založené na TPU-ponúkajú vyššiu efektivitu spracovania a nižšie využitie kremíka, čím znižujú spotrebu energie a náklady.